yolo-kiyoshi

機械学習

DistilBERTの推論速度がCPUとGPUでどれくらい変わるのか比較してみた

Google社が開発した自然言語処理モデルBERTですが、使い方次第では様々なタスクで高い精度を得られるものの、そのパラメータの多さゆえに推論にかなり時間がかかります。そのためBERTを実運用しようとすると、処理時間がボトルネックになって頓...
機械学習
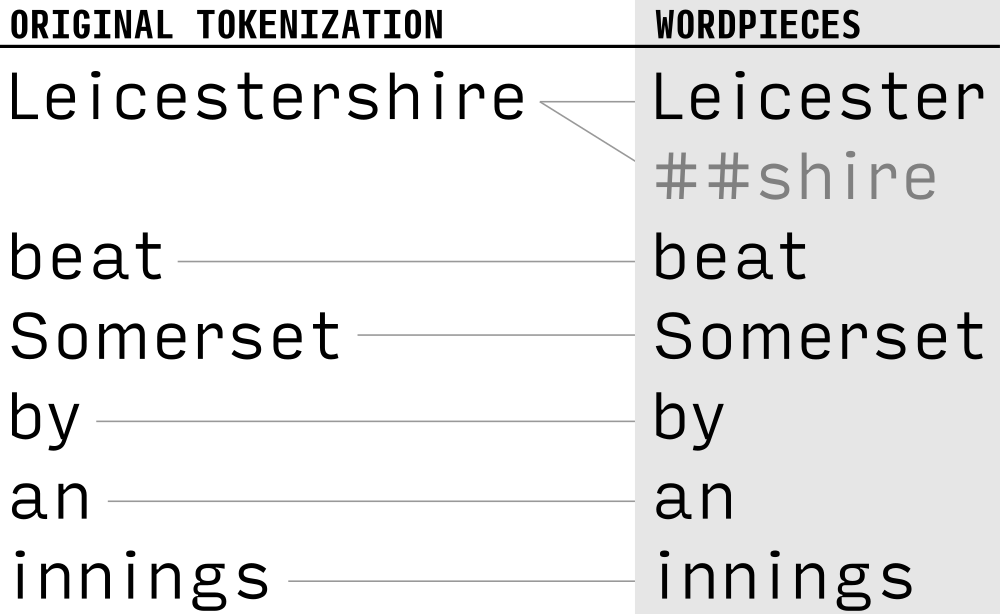
BPEでサブワード分割することでDistilBERTに未知語が入力されるのを防ぐ方法

最近案件でBERTを使う機会がありました。Hugging Face社が公開している英語版のBERTや東北大の乾・鈴木研究室が公開している日本語版BERTであれば自前のtokenizerで学習あるいは推論対象のテキストを単語分割しても問題あり...
レコメンド

実装して理解するレコメンド手法〜協調フィルタリング

前回に引き続き、推薦システムで用いられるレコメンド手法を紹介していきます。今回のテーマは協調フィルタリング(Collaborative Filtering)の実装方法です。協調フィルタリングは、多くのユーザから嗜好データを収集することで、ユ...
レコメンド

実装して理解するレコメンド手法〜コンテンツベースフィルタリング

以前、「推薦システムの手法のまとめ」という記事を書きました。この記事では、推薦システムで用いられるレコメンドモデルの全体観をまとめたのですが、各モデルの実装方法までは紹介していませんでした。ということで、今回から2回くらいに分けて推薦システ...
書評

『企画力: 人間と組織を動かす力』を読んだ感想

つい先日、職種を超えて提案書を作成するノウハウを身に付けてもらうことを目的に、社内で提案書作成講座が開かれました。その講座に参加する準備として、まずは企画する力について勉強しておこうと思って本書を読みました。実は以前、本書の著者である田坂広...
レコメンド

Word2Vecで特定のwordを除外してmost_similarする方法

レコメンドタスクでgensimのWord2Vecを利用する場合、特定のword(アイテム)を除外した上で類似度上位N件をmost_similarで出力したいことがあると思います。しかし、現時点のgensimのWord2Vecではmost_s...
機械学習

SOTAなモデルを簡単に使えるktrainがテーブルデータに対応したので試してみた

最近、自然言語処理関連の仕事でBERTを使うことになり、まずはお手軽に試せるライブラリはないかと探していたところ、ktrainというライブラリがあることを知りました。「ktrain: A Low-Code Library for Augme...
統計解析

PythonでROC曲線における最適なカットオフ値を算出する方法

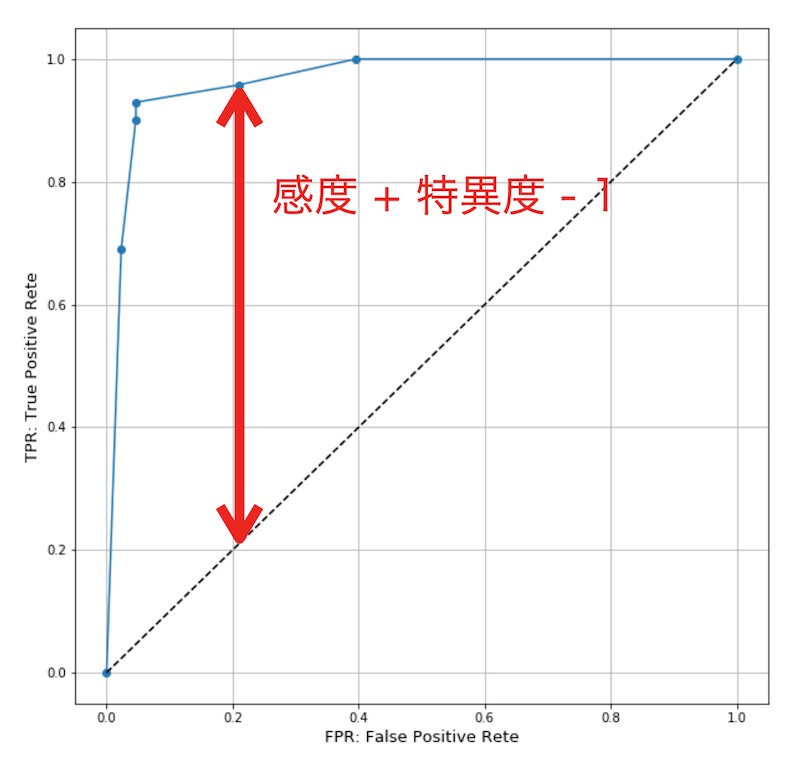
ROC曲線って、使わないとすぐに解釈の仕方を忘れてしまいます。縦軸や横軸が何を表していて、何を基準にプロットしていくのか、毎回使うときにググってしまう今日この頃です。ということで、今回は自分の記憶の整理をかねてROC曲線の可視化を実施し、最...
書評

『「具体⇔抽象」トレーニング 思考力が飛躍的にアップする29問』を読んだ感想

知人に勧められて読んでみたので、少し感想を書きます。本書の目的は次の通りです。本書は具体と抽象を往復すること、つまり抽象化と具体化によって発想を豊かにするとともに、日ごろ私たちの身の回りで起こっているコミュニケーションギャップを解消すること...
統計解析

カイ二乗検定が有意だった場合におこなう残差分析をPythonで実装する

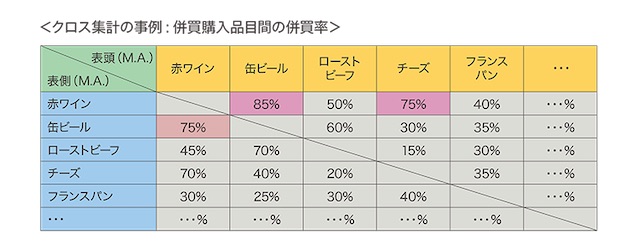
『Rで学ぶ確率統計学 多変量統計編』を読んでいて、分割表の検定の章で残差分析という手法が出てきました。カイ二乗検定の説明は市販の統計学の参考書で頻出しているものの、有意な検定結果を得られた後に実施する下位検定(post hoc test)の...