記事
施策効果の測定にはベイジアンA/Bテストを使おう!
この記事の目次 6項目
クライアント先のデータサイエンティストから、「施策検証といえば普通はA/Bテストだけど、ベイジアンA/Bテストというモダンな手法があって面白いよ!」と勧められたのでいろいろ調べてみました。
なるほど確かに、ベイジアンA/Bテストかなり使えます。
ということで、簡単にベイジアンA/Bテストを紹介しようと思います!
(Pyhtonでの実装方法や便利ツールなどは他所に詳しいのでリンクを貼っておきます)
※ちなみに、2020/6/15に弊社ブログにてStreamlitでベイジアンABテストができるWebアプリを作成した記事を書いています。
ベイジアンA/Bテスト(bayesian A/B testing)とは
ベイズ推論を使ったA/Bテストのことです。
ちなみによく使われるA/Bテストでは (カイ2乗)検定という統計手法が使われています。
ベイズ推論とは
以下のベイズの定理によりパラメータの確率分布を推論することです。
左辺は事後分布 で右辺は尤度 と事前分布 の掛け算になっています。
(分子の はパラメータ に依存せずに決まるため、A/Bテストでは無視してOKです。)
直観的なイメージは以下となります。
| 項目 | イメージ(ふわっとした定義) |
|---|---|
| 事前分布 | パラメータ の経験的な分布。CVRでいえば、だいたい10%前後だよなぁとか |
| 尤度 | パラメータ が与えられたときの の確率分布 |
| 事後分布 | 右辺のような が与えられたときのパラメータ の確率分布 |
右辺の事前分布には文字通り経験的にこうであろうと思われる確率分布を設定します。
たいていの場合、 のベータ分布 を事前分布とします。
ただ、この事前分布は経験則に基づく分布なので、観測データが入るたびにアップデートする必要があります。
(そうでないと、いつまでたっても経験則で推論することになるためです)
この事前分布は、右辺の計算結果である事後分布で更新されていきます。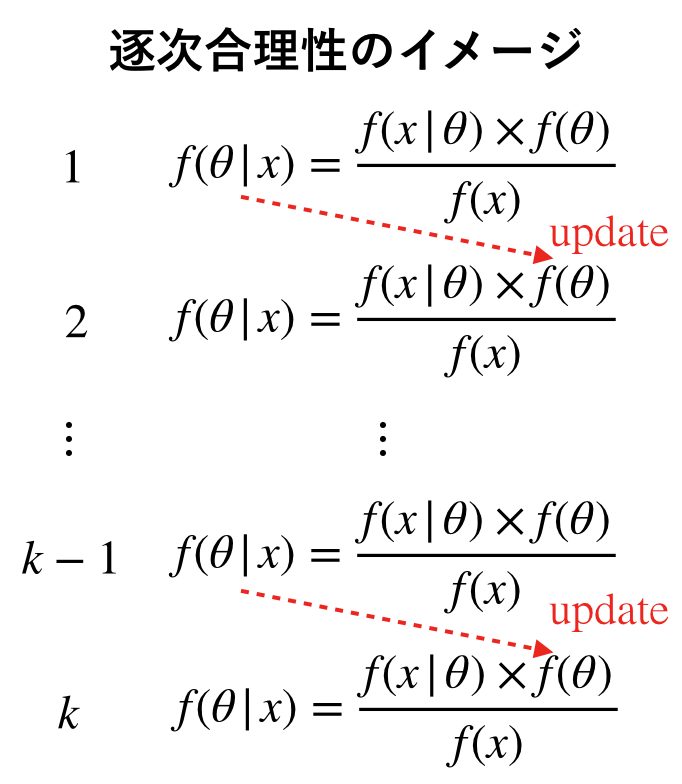
これをベイズ推論の逐次合理性と言います。
事後分布(事前分布を更新するもの)を保持しておけば、過去に使ったデータは消去して良いので、オンラインでの利用で有効です。
(参考)事前分布にベータ分布を使う理由
上でいきなり出てきたベータ分布ですが、具体的には以下の定義となります。
はベータ関数であり、上記を正規化するための定数なので、今は気にする必要ありません。ここで、先ほど述べた事前分布によく設定される のベータ分布ですが、 であり、一様分布になります。要は、事前情報がなくて良くわからない場合は、事前分布に一様分布を設定しているというだけです。また、細かい話ですが、ベータ分布の 部分がベルヌーイ分布と同じ形をしています。このため、尤度関数がベルヌーイ分布から生成される場合、尤度関数と事前分布の掛け合わせである事後分布もベータ分布 となるため、再帰的なアルゴリズムを構築できます。こういったことから、事前分布にベータ分布を使う理由となっています。
A/Bテストの問題点
A/Bテストは施策の評価でよく使われますが、統計的仮説検定をベースにしているため以下の問題点を抱えています。
- テストを始める前にテストに必要なデータがどれくらいか知っている必要がある
- リアルタイムにテストできない。
計画したデータサイズが集まるまで意思決定を保留しないといけない。 - テスト結果が直観的ではない。具体的にはP値とは何か?といった統計知識が必要になる。
- テスト結果が有意か有意でないかの白黒判断しかできない。
特に統計的に有意差がない場合に何をすべきかの理解が非常に難しい。
上記のA/Bテストで抱える問題を解消するのが、ベイジアンA/Bテストになります。
ベイジアンA/Bテストだと何が良いか
ベイジアンA/Bテストを使うことで確率的に施策の良し悪しを判断できるようになります。
- 統計知識がなくても直観的に理解できる。
つまり、ビジネスにおいてはステークホルダーとの会話がよりも容易になります。 - データサイズが少なくてもテストできる。
A/Bテストなら「全くデータがないから判断不能」となるところを、ベイジアンA/Bテストなら「Aの方がBよりも60%の確率で良い」と言える。
なるほど、ベイジアンA/Bテストはビジネスの意思決定ではかなり重宝しそうです、
ベイジアンA/Bテストの過程では多くのシミュレーションを必要とし、計算コストが大きくなりますが、現在のPCスペックでは問題にはなりませんので、ぜひこちらを活用すべきでしょう。
参考リンク
Exploratoryというツールを使った分析例
Pythonでの実装例